HTTP 狀態碼是什麼?5 大分類、常見代碼與 SEO 影響全解析
HTTP 狀態碼是伺服器在每次回應開頭回報處理結果的三位數代碼。本文拆解 5 大分類語意與 103、304、307、410、429、502、504 等常見代碼,比較 401 與 403、404 與 410 的差異,說明狀態碼對 Google 檢索與收錄的實際影響,並提供 5 種檢查方法與一套查修順序。
本頁目錄
- 狀態碼從哪裡來:一次請求的完整旅程
- 五大分類:先把家族語意記起來
- 2xx 家族:成功也有四種面貌
- 3xx 家族:重新導向與快取驗證混在同一屋簷下
- 轉址軸:301、302、303、307、308
- 快取軸:304 不是轉址
- 4xx 家族:問題多半出在請求這一端
- 401 與 403:驗證與授權是兩道不同的門
- 404 與 410:一個是沒找到,一個是不再回來
- 429:請求太多了
- 5xx 家族:伺服器端的故障與閘道瓶頸
- 502 與 504:閘道家族的兩種故障
- 503:維護期間的正確答案
- 520 到 524:內容傳遞網路自訂的代碼
- 常見狀態碼對照總表
- 狀態碼怎麼影響 SEO 與檢索
- Soft 404:回 200 的假成功
- 轉址鏈的上限與內容歸屬
- 檢索頻率怎麼被調節
- 200 只拿到入場券
- 五種檢查方法:從單頁到全站
- 命令列:一支指令問到底
- 開發者工具:看見單頁真相
- 線上檢查工具:批次處理大量網址
- Search Console:搜尋引擎親口告訴你
- 伺服器存取記錄:全站的最終真相
- 遇到錯誤碼的查修順序
- 三個排查情境
- 案例一:改版後的接力轉址
- 案例二:整週流量下滑的元兇是 403
- 案例三:把維護期做對的 503
- 把狀態碼當成網站的體檢數值
打開 Google Search Console,報表裡跳出一排 404;工程師在群組裡回報「現在整站 502」;客服信箱收到使用者詢問,為什麼你的網站顯示無法存取。這些情境背後都是同一件事:你的網站正在用 HTTP 狀態碼跟世界對話,只是你未必聽得懂它在說什麼。
每次有人(或某支程式)向網站請求一個網址,伺服器都會在回應的開頭回報一組三位數字,這組數字就是 HTTP 狀態碼(HTTP Status Code),負責交代這次請求的下場:內容順利送出了、網址搬到新家、訪客沒有權限,或者伺服器自己出了狀況。這套代碼的核心語意主要由 HTTP 通訊協定標準 RFC 9110 定義,部分代碼另有後續擴充規範,也存在服務商自訂的成員,MDN 的 HTTP 狀態碼總覽依五個號碼區段把全部代碼整理成可查詢的清單,是工程師與 SEO 工作者共同依賴的參考來源。
讀懂狀態碼之所以重要,在於所有造訪你網站的程式都依賴它做決定。瀏覽器看到 301 會自動換網址再請求一次;搜尋引擎檢索器看到 404 會把頁面從索引移除;快取系統看到 304 會沿用本地副本;API 串接的對象看到 429 會知道要放慢腳步。同一套數字,瀏覽器看得懂,Googlebot 看得懂,你委託的技術團隊也看得懂。換句話說,狀態碼是網站對外溝通的共通語言,設定錯了,等於對所有訪客同時傳達錯誤訊息。
接下來先走完一次請求的完整旅程,說明狀態碼在回應裡的位置,再逐一拆解五大分類的語意與每個家族裡真正會遇到的代碼,包括多數入門文章不會展開的 103、204、304、307、410、429、502、504,以及 Cloudflare 體系特有的 520 系列。後半段聚焦兩件實務的事:狀態碼如何影響 Google 的檢索與收錄,以及五種檢查方法與一套查修順序,讓你下次在報表裡看到異常數字時,知道從哪裡下手。
這套知識的適用對象比想像中廣。行銷人員需要在流量下滑時判斷問題屬於內容還是技術;接案顧問需要在驗收網站時快速體檢;寫程式的人需要理解自己設定的規則會對搜尋引擎產生什麼副作用;自己架站的創業者更需要省下往返溝通的時間,第一時間看懂主機與外掛丟出來的訊號。狀態碼剛好停在技術與行銷的交界上,花一次時間把它讀通,日後每一份報表、每一次事故都會用得上。
狀態碼從哪裡來:一次請求的完整旅程
在瀏覽器網址列輸入一個網址並按下 Enter,背後展開的是一連串標準化步驟。瀏覽器先透過 DNS 把網址翻譯成伺服器的 IP 位址,接著與伺服器建立連線,然後送出 HTTP 請求。請求會指定要使用的 HTTP 方法(取得頁面用 GET,送出表單用 POST)與要存取的路徑,並帶上一組請求標頭,例如使用者代理、可接受的內容格式與快取狀態;依方法與用途不同,還可能附帶內容本體,例如表單要送出的資料。
伺服器收到請求、處理完之後回傳 HTTP 回應。回應同樣有三個部分,而狀態碼就住在第一行,叫做狀態列。打開瀏覽器開發者工具的 Network 面板點開任何一個請求,會看到類似「HTTP/1.1 200 OK」或「HTTP/1.1 301」的狀態列(HTTP/2 之後改用 :status 欄位承載同一組數字,面板上一樣看得到),後面才接著內容類型、快取控制等回應標頭,以及頁面本體。狀態碼是伺服器對這次請求的總結答覆,標頭是補充說明,內容則是貨物本體。
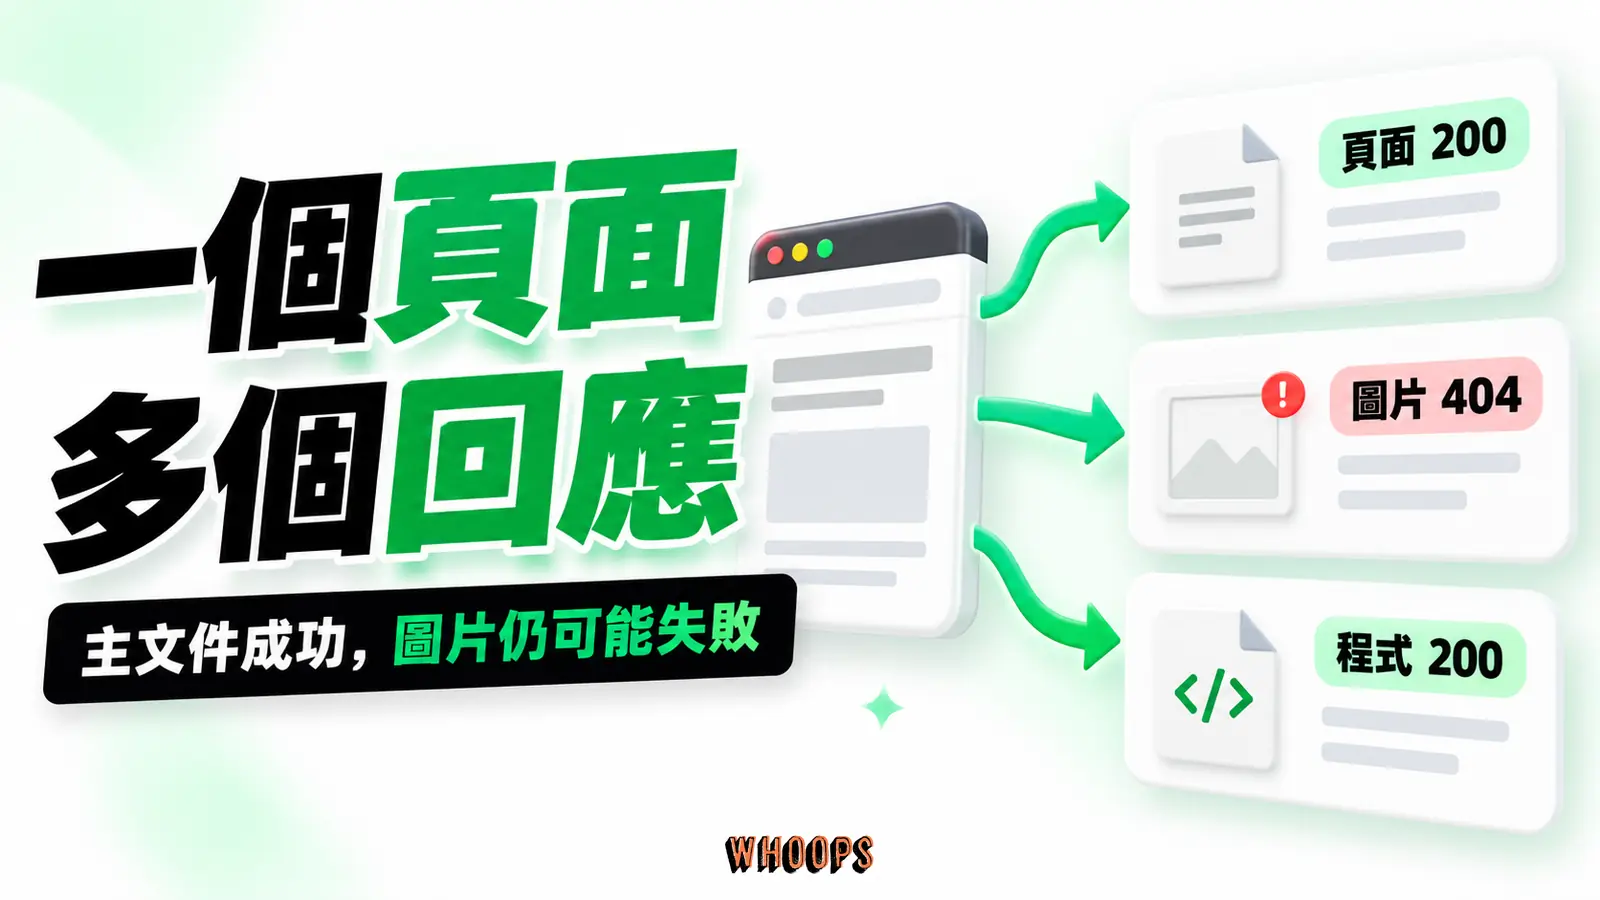
有個容易被忽略的事實:載入一般網頁,通常會發出多個請求。HTML 主文件是一個請求,頁面上的每一張圖片、每一支 CSS 與 JavaScript 檔案、每一個背景資料呼叫,都是獨立的請求,各自拿到自己的狀態碼。頁面看起來半殘,圖片全破圖,常常代表主文件回 200 而部分資源回 404 或 500。遇到重新導向時,每一跳也是一個完整的請求與回應,瀏覽器拿到 301 之後自動改請求 Location 標頭裡的新網址,於是一條轉址鏈會產生一整串狀態碼,而不是一個。
請求方法與狀態碼之間也有對應關係。送出 POST 建立新資料時,201 表示資源已建立,回應可附上建立的結果;204 表示成功但回應不附內容。用 GET 去打一個只接受 POST 的端點,伺服器會回 405,告訴你方法用錯了,資源本身存在。理解這層對應,看到狀態碼時就能多問一句:這個請求當初是用什麼方法送出去的。
還需要先破除一個觀念:狀態碼不等於錯誤訊息。2xx 表達成功,3xx 表達資源換位置或不必重傳,這些都是正常溝通的一部分,瀏覽器時時刻刻都在處理 200 與 304 而不會顯示任何異常。會讓訪客吃閉門羹的主要是 4 開頭與 5 開頭,不過連它們也未必代表網站壞掉,401 就只是提醒訪客先登入。把狀態碼當成體檢報告上的數值而非警報器,判斷才不會失準。
五大分類:先把家族語意記起來
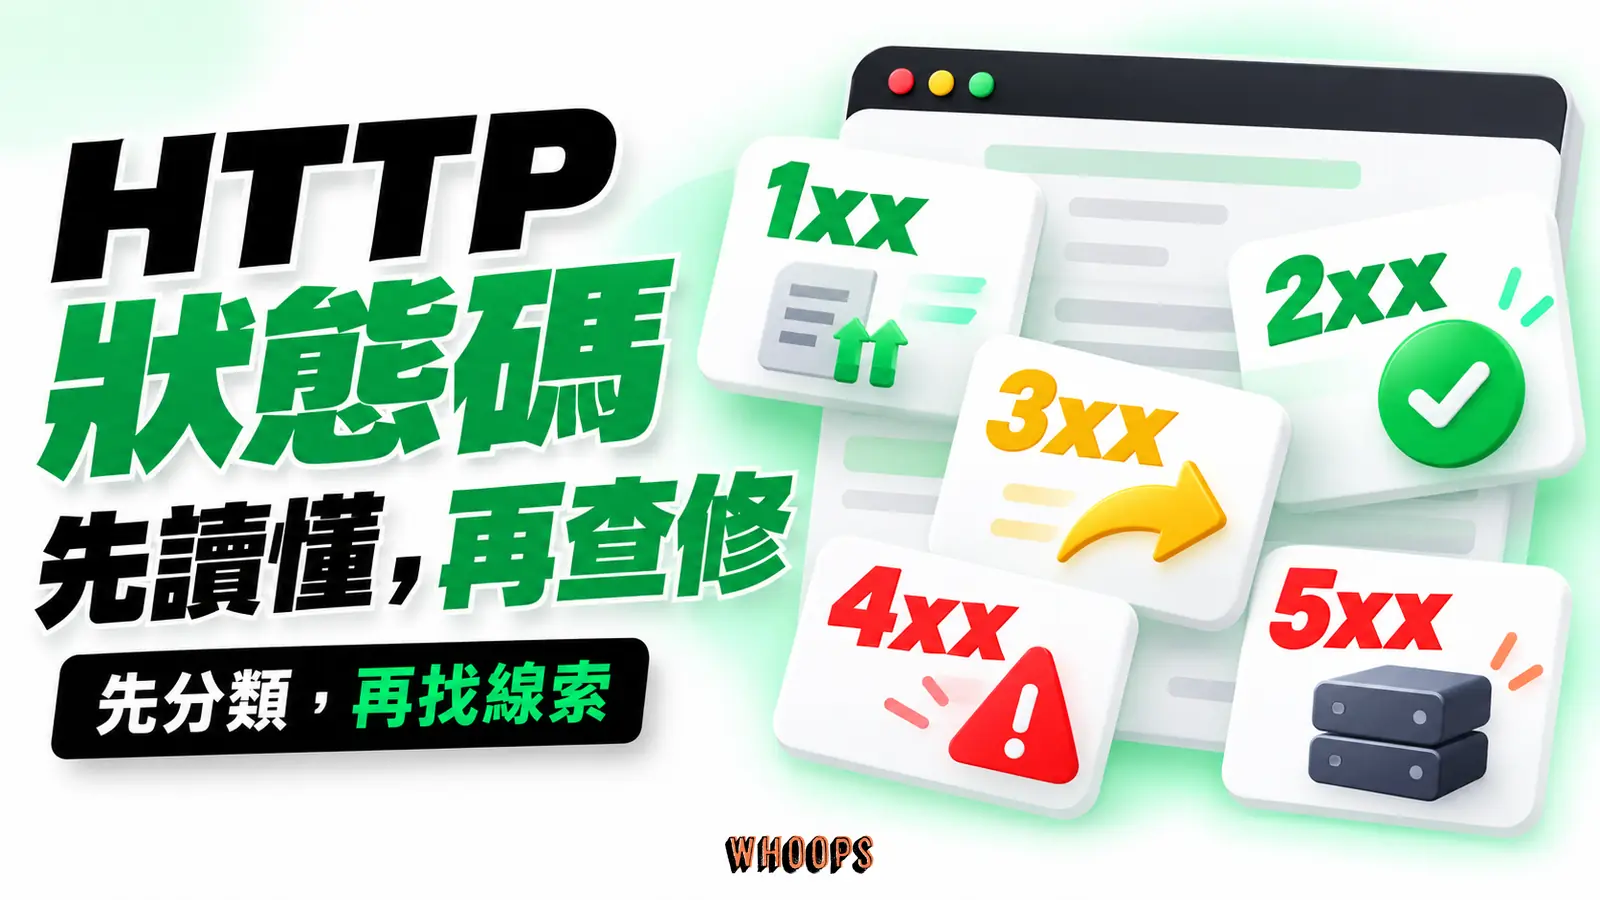
狀態碼的第一個數字決定它屬於哪個家族,五個家族各自表達一種大方向。與其硬背幾十個代碼,先記住五句話:1xx 是還在講話,2xx 是事情成了,3xx 是換地方或不必重傳,4xx 是請求端有問題,5xx 是伺服器端有問題。日後看到任何陌生的碼,看開頭數字就能立刻定位問題出現在誰身上,再往下查細項。
左右捲動檢視完整表格
| 分類 | 號碼區間 | 家族語意 | 常見代碼 | 站長的第一反應 |
|---|---|---|---|---|
| 資訊回應 | 100 至 199 | 請求已收到,處理仍在進行 | 100、103 | 通常無需動作,交給瀏覽器與伺服器處理 |
| 成功回應 | 200 至 299 | 請求已成功處理 | 200、201、204、206 | 確認回傳內容本身正確即可 |
| 重新導向 | 300 至 399 | 資源換位置,或快取仍有效 | 301、302、304、307、308 | 檢查 Location 是否指向正確目的地 |
| 用戶端錯誤 | 400 至 499 | 請求本身有問題或無權存取 | 400、401、403、404、410、429 | 確認網址、權限與請求格式是否正確 |
| 伺服器錯誤 | 500 至 599 | 伺服器無法完成有效回應 | 500、502、503、504 | 查主機、應用程式與上游服務狀態 |
1xx 家族平常幾乎不會出現在一般網頁瀏覽的畫面上,但它的兩個成員值得認識。100 Continue 搭配請求裡的 Expect 標頭運作,讓用戶端先探詢伺服器是否準備好接收大量內容,避免白傳一大包資料過去卻被拒收。103 Early Hints 則更積極:伺服器在正式回應準備好之前,先送出提示,讓瀏覽器提早預先載入 CSS 或預先建立對第三方網域的連線,縮短最終頁面的可互動時間。它的實作通常搭配 Link 標頭,主流瀏覽器與部分內容傳遞網路已經支援,對講究效能的網站來說,103 是值得與工程團隊討論的加速選項,特別適合首頁與關鍵著陸頁這種資源多、等待時間敏感的頁面。
號碼區段之外還有一個補充觀念:並非所有出現過的狀態碼都寫在標準裡。實務上會遇到一些伺服器或服務自行定義的代碼,例如內部系統的 599,或後面會談到的 Cloudflare 520 系列。MDN 在總覽裡特別提醒,遇到清單上沒有的回應時,它可能是伺服器自行定義的非標準狀態碼,查閱該服務的文件往往比翻 RFC 更快找到答案。
2xx 家族:成功也有四種面貌
200 OK 是最常見的成功回應,代表伺服器順利處理並回傳內容;對一般的頁面請求來說,瀏覽器拿到的就是完整頁面,實際內容仍依請求方法與資源種類而異。對 SEO 而言 200 是理想狀態,但 Google 的文件說得很明白:200 回應的內容會進入後續處理,但不保證一定被收錄。收錄與否另有一套判斷,內容品質、標準網址的選擇都會介入,這點在後面的 SEO 段落會再展開。
201 Created 多出現在 API 與表單處理的場景,表示請求成功了,而且伺服器因此建立了新資源,例如新增一筆會員資料或一篇文章。204 No Content 同樣表達成功,但回應裡沒有內容本體,典型的使用時機是刪除完成或更新完成,用戶端只需要知道事情辦好了,不需要再收一份文件。這兩個碼在網頁前台很少直接遇到,卻是串接後台與第三方服務時判讀邏輯的重要依據。Google 的檢索說明對 204 另有一個提醒:網頁型網址若回 204,檢索器拿不到任何可處理的內容,等於空手而歸,頁面自然無法被收錄。
206 Partial Content 則與大檔案下載有關。瀏覽器或續傳工具以 Range 標頭請求資源的一部分,伺服器同意後回 206,只送出指定的區段。範圍請求能支應影片進度跳轉、PDF 邊載入邊顯示前幾頁這類功能;線上串流也常改用獨立的媒體分段來實作,206 並非唯一解,卻是 2xx 家族裡最常被忽略的一員。
3xx 家族:重新導向與快取驗證混在同一屋簷下
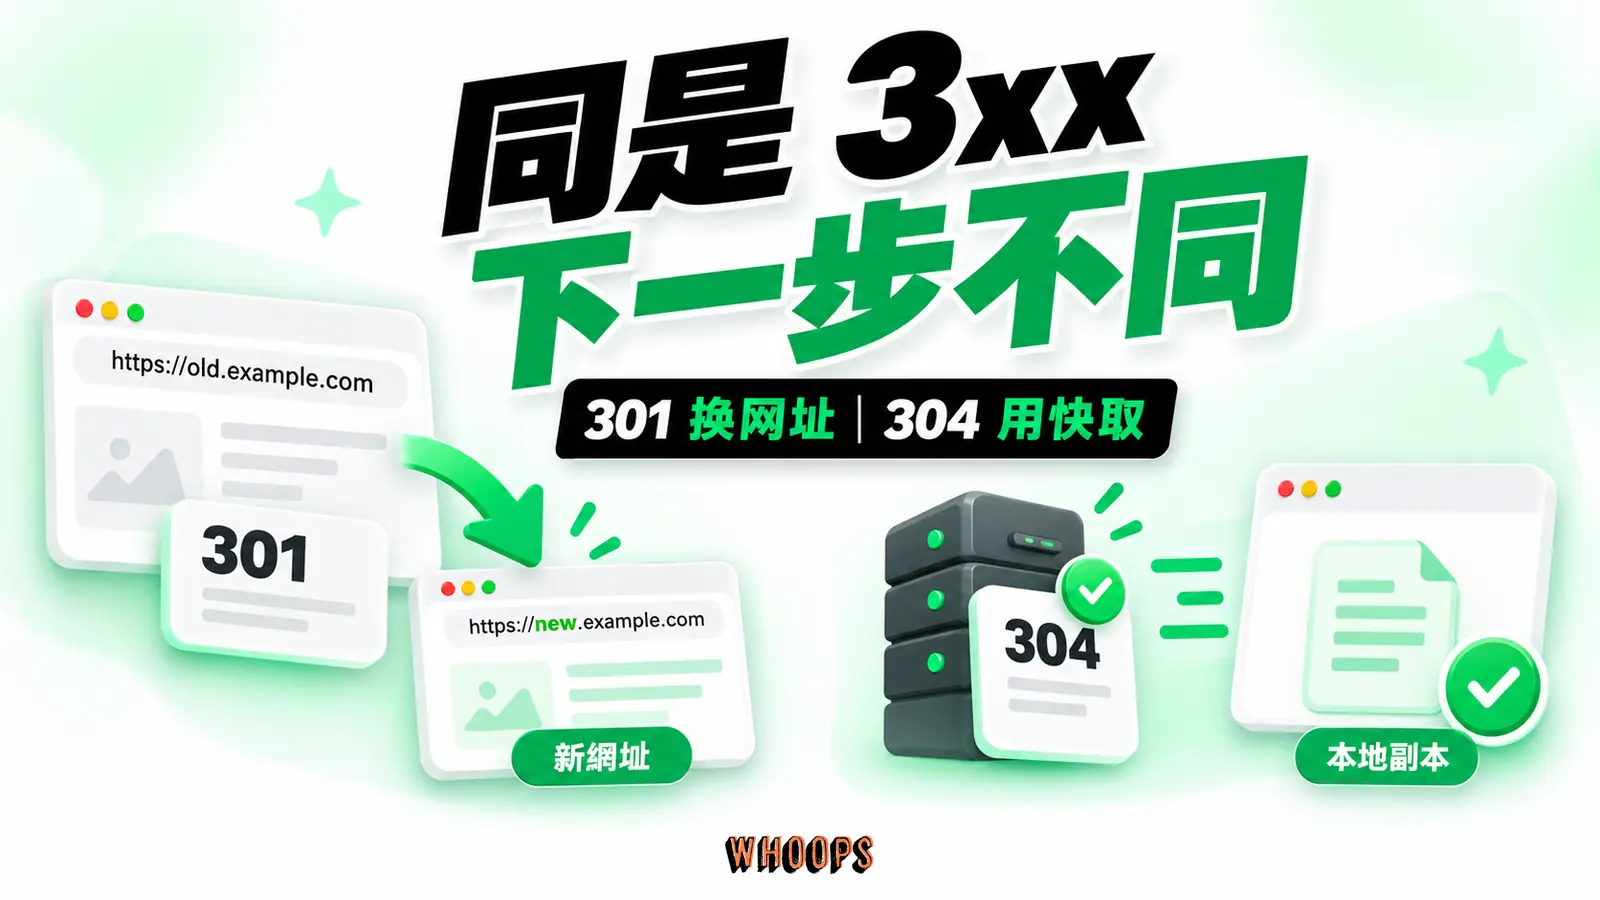
3xx 是最容易被誤解的一族,因為它同時容納兩種性質完全不同的回應。一種是重新導向,告訴用戶端資源換位置了,請改去新網址拿;另一種是快取驗證,告訴用戶端你手上的副本還能用,不必重傳。兩者共用 3 開頭這個家族,但行為與應對方式天差地遠,混為一談會導致錯誤的技術決策。
轉址軸:301、302、303、307、308
301 Moved Permanently 表達永久搬遷,302 Found 表達暫時換位置。對搜尋引擎來說,這兩個碼是理解網址關係的重要訊號,永久與暫時的差異會影響標準網址的判斷與權重移轉的方向。挑選原則、常見陷阱與上線後的驗證清單,可以搭配轉址選 301 或 302 的完整判斷流程一起看,這裡先把焦點放在家族內部的差異。
307 Temporary Redirect 與 308 Permanent Redirect 是相對年輕的成員,存在的目的只有一個:補上 301 與 302 在實作上長年累積的歷史包袱。301 與 302 在規格上容許用戶端基於歷史相容性,把 POST 換成 GET 重新請求,於是 POST 過去的資料在轉址後可能就此消失。307 與 308 從規格層面把這件事說死:MDN 對 307 的說明寫明重新導向時沿用原本的請求方法與內容本體,308 對永久版做同樣的保證。涉及表單送出或 API 呼叫的轉址情境,改用 307 或 308 能避免方法被偷換的隱患。
家族裡還有一個扮演相反角色的成員。303 See Other 表達「請去另一個網址用 GET 看結果」,適合表單送出後導向確認頁的情境,設計上就是要把方法換成 GET,避免重新整理時重複送出資料。整理成一句話:要保留方法用 307 或 308,要換成 GET 用 303,301 與 302 則留給單純的網址搬移與暫時跳轉。
快取軸:304 不是轉址
304 Not Modified 平時不會被使用者看見,常見於快取需要重新驗證的請求。流程是這樣:瀏覽器曾經載入過某個資源,本地留有快取副本;快取仍新鮮時可以直接取用,等到需要驗證時,才會帶著 If-None-Match 或 If-Modified-Since 標頭去問伺服器,我的副本還有效嗎。若資源沒變,伺服器回 304,不帶內容本體,瀏覽器直接沿用快取。MDN 對 304 的說明把它歸在重新導向類別之下,同時也說明它屬於快取驗證回應,功能是省流量與加速,跟「頁面搬家」沒有任何關係。
對站長的實際意義有兩個。第一,在開發者工具裡看到大量 304 不必緊張,那是快取正常運作的痕跡,開發時若強制停用快取重新載入,原本回 304 的請求就會改為完整的 200 回應。第二,304 依賴回應標頭裡的快取控制設定,例如 ETag 與 Last-Modified,設定得當能明顯降低重複流量,這與頁面載入速度的優化方向一致,值得與前述的 103 Early Hints 一併納入效能規劃。
4xx 家族:問題多半出在請求這一端
4 開頭的碼向請求端喊話:你的請求有問題,或你沒有資格拿到這份資源。400 Bad Request 是最泛用的拒絕,請求格式錯誤、參數缺漏都可能觸發。408 Request Timeout 是用戶端送請求太慢,伺服器等不及。409 Conflict 表示請求與資源現況衝突,同時編輯同一筆資料就是典型例子,屬於正常的並行衝突通報。這三個碼背後的原因不同:400 多半指向格式或參數有誤,408 常與網路延遲或連線閒置有關,409 則要看資源狀態;在前台遇到時,先檢查產生請求的連結與參數。
401 與 403:驗證與授權是兩道不同的門
401 Unauthorized 與 403 Forbidden 是最常被混為一談的一組。401 Unauthorized 表達的是身分問題:伺服器要求你先通過驗證,可能因為你還沒出示憑證,或出示的憑證無效,而且依規格必須附上 WWW-Authenticate 標頭說明驗證方式。403 Forbidden 表達的則是拒絕執行:伺服器看得懂這個請求,卻基於權限不足、IP 限制或防護規則直接說不,而且未必經過身分驗證這一關,重新登入常常也改變不了結果。
用一棟辦公大樓來比喻,401 是櫃檯請你先出示識別證;403 是對方明白你要什麼之後直接搖頭,原因可能出在你的單位不在名單上、這個樓層不對外,或者警衛對你的來歷有疑慮。查修方向因此完全不同:滿頁 401 先檢查登入狀態與憑證傳遞,滿頁 403 則檢查權限設定、IP 限制與防護規則。有一種 403 特別值得 SEO 工作者警戒:網站應用層防火牆把合法爬蟲誤認為攻擊流量而整批擋下,症狀是搜尋流量無預警下滑,判斷與處理方式可以參考WAF 防火牆的運作原理與爬蟲誤擋排查。
404 與 410:一個是沒找到,一個是不再回來
404 Not Found 是全世界最出名的狀態碼,代表伺服器找不到請求的資源。它可能是網址打錯、頁面被刪除,也可能是內部連結指向了不存在的路徑。410 Gone 語意更重:這份資源已經永久移除,而且預期不會恢復。MDN 對 410 的說明建議,唯有確定資源永遠不回來時才使用 410,若不確定是暫時還是永久,就回 404。
很多站長直覺以為 410 會讓 Google 更快把頁面從索引刪掉,於是把大量 404 改成 410。實際情況需要回到官方文件檢視:Google 對檢索狀態碼的說明把 404 與 410 放在同一組處理邏輯裡,同樣是告知索引系統內容不存在、已收錄的頁面會被移除、這些網址的再檢索頻率逐漸下降,並沒有明文給出不同的處理時程。410 的真正價值在於 HTTP 語意層:對其他搜尋引擎、下載工具與自動化程式明確表達永久移除,讓它們不必反覆回來確認。若目標只是清理 Google 索引,404 已經足夠。
面對大量 404,與其急著全部轉址,更該先分類處理:有對應新頁面的,設定 301 指向語意最接近的新網址;確定永久消失的,讓它誠實回 404 或 410;至於造訪者真的會撞到的 404 頁面,把它設計成一條留客動線,引導搜尋或回到熱門分類,做法可以參考404 頁面設計的實作技巧。轉址不是 404 的唯一解,有時讓不存在的事情誠實地不存在,對網站反而更健康。
429:請求太多了
429 Too Many Requests 表達用戶端在一段時間內送出過多請求,觸發了速率限制,這是 API 服務與爬蟲攻擊防護的標準回應。回應裡可以附上 Retry-After 標頭,告知對方多久之後再試。對經營 API 或提供資料介面的網站來說,429 是保護伺服器的必要機制;對呼叫別人服務的開發者來說,收到 429 代表需要處理退避與重試邏輯。
SEO 工作者需要特別記住一個反直覺的事實:Google 把 429 視為伺服器錯誤來處理。官方檢索說明寫得直接,檢索器收到 429 會解讀為伺服器過載,並且像對待 5xx 一樣暫時放慢檢索。也就是說,如果你用速率限制規則把 Googlebot 擋成 429,在 Google 眼中網站等於故障中,檢索頻率會跟著下降。要長期控制檢索量,正確的工具是 robots.txt;Search Console 曾經提供的檢索頻率設定已在 2024 年 1 月移除,Googlebot 現在依伺服器回應自動調整速度。另一個容易混淆的點:Google 現行指引確實允許在伺服器過載時,以 429 或 503 短期回應(數小時到一兩天)為整個主機降載,這與防護規則無意間把 Googlebot 擋成 429 是兩回事,後者會讓 Google 以為網站出狀況而放慢檢索。
5xx 家族:伺服器端的故障與閘道瓶頸
5 開頭的碼向伺服器(以及站在伺服器前面的整個服務鏈)喊話:問題在我們這邊。500 Internal Server Error 是最泛用的一種,伺服器遇到預期外的狀況而無法完成請求,程式錯誤、資料庫連不上、設定檔寫錯都可能以 500 的面貌出現。它是一個症狀描述,真正的病因要往應用程式日誌裡找。
追蹤 500 有幾個實用的縮小範圍法。先確認是全站或特定路徑,只有某類頁面掛掉通常指向該功能的外掛或程式模組;再對照錯誤出現的時間與最近的變更紀錄,更新、部署與設定調整是三大常見觸發點;有辦法重現時,在測試環境打開除錯模式,讓錯誤訊息完整現形。使用 WordPress 的網站另有兩個高頻原因值得優先檢查:PHP 版本與外掛需求不相容、佈景主題檔案出現語法錯誤,兩者通常都能在錯誤日誌裡找到直接線索。
502 與 504:閘道家族的兩種故障
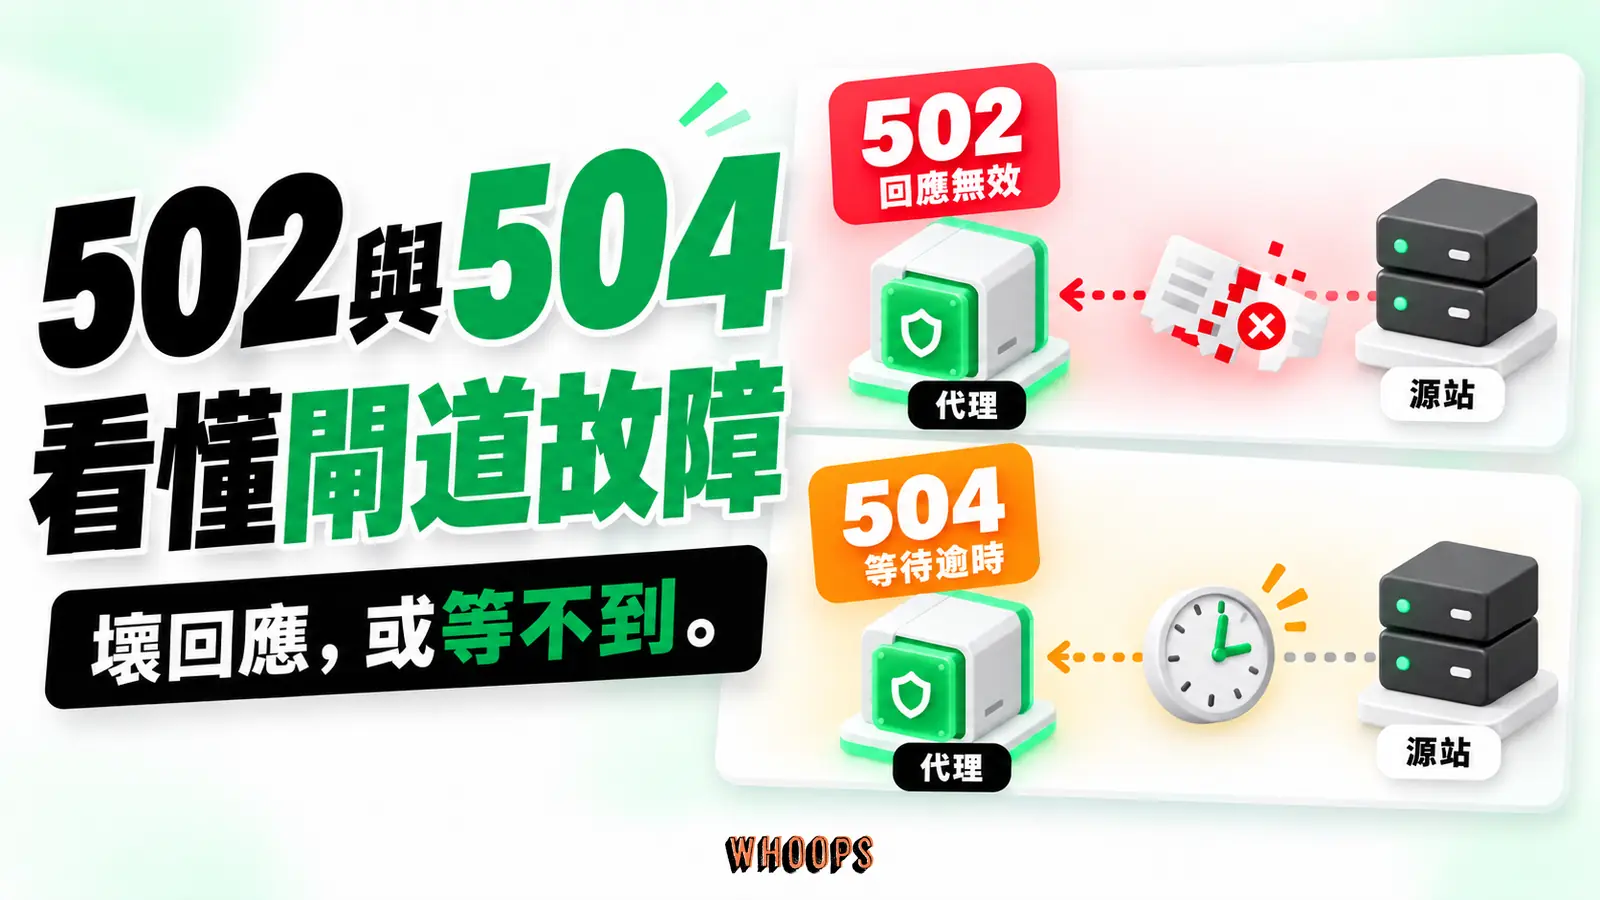
現代網站的架構裡,瀏覽器面對的通常不是網站主機本身,而是內容傳遞網路或負載平衡器這類代理層,代理層再回頭向源站伺服器要資料。502 Bad Gateway 與 504 Gateway Timeout 都是在這段代理與源站的對話中出問題:502 代表代理收到上游回應,但那份回應無法理解,或者上游根本拒絕了連線;504 代表上游在期限內沒有回應,代理等不到答案只好放棄。
兩者的查修方向不同。502 常見原因是源站程式崩潰、回傳格式錯誤,或源站主動拒絕代理的連線;504 則多半是源站太慢,資料庫查詢卡住、外部服務延遲、流量瞬間暴增都會讓回應時間超過閘道上限。看到 504 先問應用程式哪個環節變慢了,看到 502 先問源站還活著嗎。整站 502 或 504 期間,對外呈現的狀態就是服務不可用,對檢索與轉換都是實打實的傷害。
503:維護期間的正確答案
503 Service Unavailable 表達伺服器暫時無法提供服務,常見原因正是計畫性維護或瞬間過載。MDN 對 503 的說明給出兩個重要建議:這個碼只用於暫時性的狀況,並且盡量在 Retry-After 標頭註明預計恢復時間,同時搭配一頁清楚說明狀況的友善頁面。對搜尋引擎而言,503 傳達的是「現在休息,晚點再來」,搭配 Google 對 5xx 家族放慢檢索的行為,短暫維護通常不會造成收錄損失。
實務上要避免兩種常見的錯誤做法。一是維護期間把所有頁面 302 導向首頁,這會讓檢索器與使用者都拿到語意不合的內容,比誠實回 503 更傷;二是讓 503 無限期持續,Google 的說明指出,長期回傳伺服器錯誤的網址最終會從索引中移除。整個網站都無法提供服務時,計畫性維護的正確組合是:深夜低流量時段、全站 503、Retry-After 標頭、一頁清楚的維護說明,結束後恢復正常回應,檢索節奏會自然回來;若只是部分功能維護,把 503 限定在受影響的資源即可。
520 到 524:內容傳遞網路自訂的代碼
如果你的網站放在 Cloudflare 這類內容傳遞網路後面,報表裡可能出現標準裡不存在的 5 開頭代碼。520 代表源站回傳了未知錯誤;521 代表源站主機掛了或拒絕連線;522 是代理與源站之間的 TCP 連線逾時;523 是源站所在的網路不可達;524 則是連線建立了、源站卻在期限內沒有回完 HTTP 回應。Cloudflare 的 5XX 錯誤疑難排解文件對每個代碼都有專頁說明,出現時先對照文件定位環節,再往源端或網路端排查。
這組代碼存在的意義,是把「代理與源站之間發生了什麼」講得比標準 5xx 更細。對站長的價值在於快速分工:521 與 523 指向源站主機與所在網路,先找主機商;522 偏向連線層,檢查源站防火牆是否擋了代理的 IP 段、網路與主機負載;524 是連線建立後等不到回應,往應用程式與資料庫的回應速度查;520 需要進一步看源站回傳的原始內容。讀懂這組非標準碼,等於多了一份代理層視角的診斷線索。
常見狀態碼對照總表
把前述家族整理成一張可收藏的對照表。語意欄力求口語,處理欄給站長可直接行動的方向,遇到報表異常時先查表定位,再回頭讀對應家族的細節。
左右捲動檢視完整表格
| 狀態碼 | 名稱 | 白話語意 | 站長該做的事 |
|---|---|---|---|
| 100 | Continue | 可以繼續送資料 | 無需處理,屬協定層溝通 |
| 103 | Early Hints | 先給提示,正式回應稍後到 | 可與工程師評估用於預先載入資源 |
| 200 | OK | 成功回傳內容 | 確認內容正確即可 |
| 201 | Created | 成功而且建立了新資源 | API 場景確認資料落地 |
| 204 | No Content | 成功但沒有內容 | 頁面型 URL 出現時檢查是否誤用 |
| 206 | Partial Content | 只回傳資源的一部分 | 正常機制,支援續傳與影片拖曳 |
| 301 | Moved Permanently | 永久搬到新網址 | 確認指向正確,避免鏈狀轉址 |
| 302 | Found | 暫時換位置 | 確認暫時性質成立,別久放 |
| 303 | See Other | 請改用 GET 去看結果 | 表單送出後導向確認頁的標準做法 |
| 304 | Not Modified | 快取副本仍有效 | 屬快取驗證,非轉址,無需緊張 |
| 307 | Temporary Redirect | 暫時轉址且保留請求方法 | 需保留請求方法的表單與 API 轉址適用 |
| 308 | Permanent Redirect | 永久轉址且保留請求方法 | API 與表單的永久搬遷首選 |
| 400 | Bad Request | 請求格式有誤 | 檢查產生請求的連結或程式碼 |
| 401 | Unauthorized | 先通過身分驗證 | 檢查登入狀態與憑證 |
| 403 | Forbidden | 理解請求但拒絕執行 | 檢查權限、IP 與防護規則 |
| 404 | Not Found | 找不到這份資源 | 分類處理:轉址、修連結或保留 |
| 405 | Method Not Allowed | 方法用錯了 | 確認請求方法與端點定義 |
| 410 | Gone | 永久移除且不會回來 | 確定永不恢復才使用 |
| 429 | Too Many Requests | 請求太頻繁被限流 | 檢查限流規則是否誤傷合法爬蟲 |
| 500 | Internal Server Error | 伺服器內部出錯 | 查應用程式日誌找真正病因 |
| 502 | Bad Gateway | 上游回應無效 | 確認源站存活與回應格式 |
| 503 | Service Unavailable | 暫時無法提供服務 | 維護期搭配 Retry-After 使用 |
| 504 | Gateway Timeout | 上游回應逾時 | 找讓源站變慢的環節 |
| 521 到 524 | CDN 自訂碼 | 代理與源站之間的細部故障 | 對照 CDN 文件定位是主機、網路還是效能 |
狀態碼怎麼影響 SEO 與檢索
Soft 404:回 200 的假成功
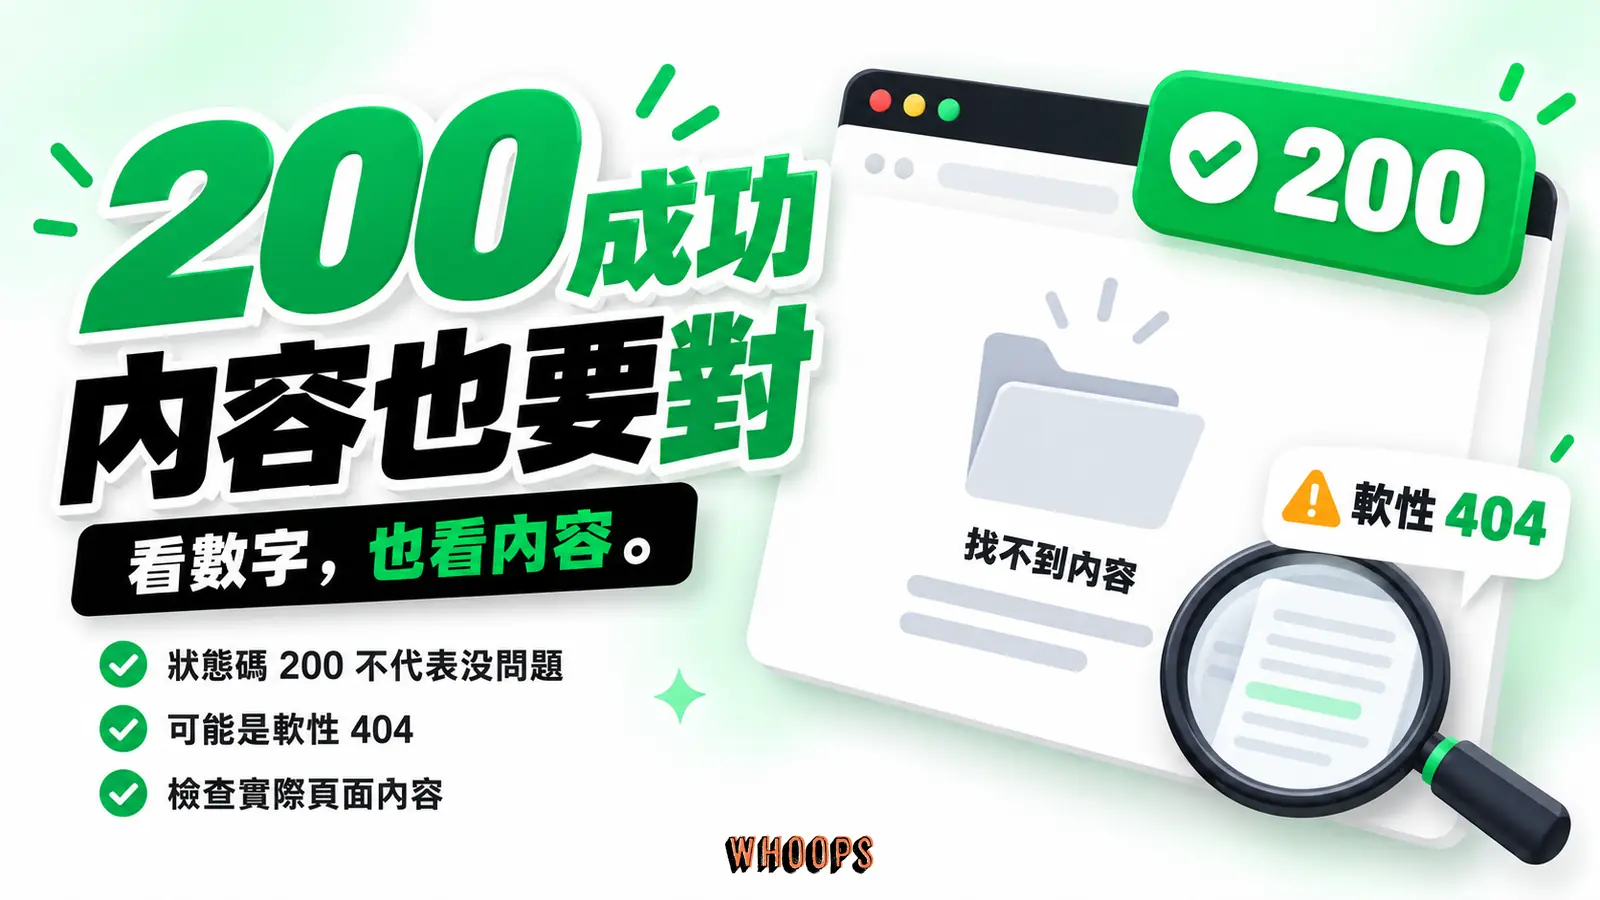
比 404 更難纏的,是一種偽裝成成功的失敗。站內搜尋把打錯的關鍵字帶到一頁「沒有符合結果」,系統把停售商品導向內容毫不相干的促銷頁,這類網址回的是 200,訪客看到柔和的訊息,機器卻把它當成一般頁面來讀。先把界線畫清楚:把下架商品轉到仍有實質內容的相關分類頁,通常屬於合理轉址,未必構成問題;真正的判定標準在回應內容本身。Google 的對策正是看內容而不只看數字:官方對檢索狀態碼的說明提到,當回應內容是空頁面或錯誤訊息時,Search Console 會以軟性 404 標記這個網址。代價有兩層:它以成功回應的身分占用檢索資源;Search Console 雖然會以軟性 404 這個類別把它點名,它卻不會被計入一般的 404 統計,不熟悉報表的人很容易漏看。讓不存在的頁面誠實回 404,確定永不回來的再升級成 410,帳目才會乾淨。
轉址鏈的上限與內容歸屬
重新導向鏈不是無限延伸的。同一份 Google 說明寫明,檢索器預設最多跟隨十次重新導向跳躍,超過之後就放棄,而 Search Console 對失敗的轉址會回報重新導向錯誤。更值得留意的是內容歸屬規則:轉址過程中來自原始網址的任何內容都會被忽略,Google 處理的是最終目標網址的內容。這代表兩件事:鏈狀轉址要收斂成一跳,中間頁面寫了什麼補救文字都救不回來;改版時的網址對應表要一次規劃到位,疊床架屋的接力轉址會把檢索預算耗在旅途上。搬遷規劃的完整風險清單,可以參考網站搬家與改版的 SEO 風險控制。
檢索頻率怎麼被調節
Google 文件對各家族的檢索行為有清楚交代。5xx 與 429 會促使檢索器暫時放慢腳步,放慢的幅度與回傳錯誤的網址數量成正比;已收錄的網址在錯誤持續很久之後終究會從索引移除,等伺服器恢復正常回應,檢索頻率會逐步回升。4xx 家族除了 429 之外,不會像 5xx 那樣壓低整個網站的檢索速率,官方也明說 401 與 403 不該拿來限制檢索;要長期控制檢索量走 robots.txt,伺服器真的過載時,現行指引允許以 429 或 503 短期為整個主機降載。理解這組規則,就能看懂為什麼主機不穩的網站會出現收錄量緩慢下滑的曲線。
換個角度想,檢索頻率本身就是一種資源帳本。搜尋引擎分配給每個網站的檢索量有限,花在追轉址鏈、反覆檢索軟性 404、等待逾時上的次數,全部都記在同一本帳上;至於誠實回 404 或 410 的已移除網址,Google 在檢索迷思的說明裡講得直接,一般 4xx 不會浪費檢索預算。把狀態碼照顧好,等於把帳本上真正的浪費刪掉,讓檢索資源集中在需要被收錄與更新的頁面上。這也是為什麼大型網站特別在意轉址鏈收斂與軟性 404 治理,規模越大,帳本上的每一筆浪費都被放大。
200 只拿到入場券
回到最容易被誤讀的一件事:全站回 200 不等於 SEO 健康檢查過關。狀態碼負責的是「能不能被順利讀取」,收錄與排名屬於下一關,由內容品質、重複內容的處理與標準網址訊號共同決定。狀態碼層面的正確,是必要條件而非充分條件。搜尋引擎分配給一個網站的檢索資源有限,想把這份資源花在刀口上,可以延伸閱讀爬取預算的概念與優化策略,把檢索、索引與網站結構放到同一張地圖上檢視。
五種檢查方法:從單頁到全站
命令列:一支指令問到底
伺服器怎麼回應不帶瀏覽器渲染的原始請求,用命令列最誠實。在終端機輸入這兩行指令,把網址換成要查的頁面:
curl -I https://example.com/your-slug
curl -sS -D - -o /dev/null https://example.com/your-slug
第一行指令帶 -I,送出的是 HEAD 請求,只取標頭不取內容,輕量快速,但少數伺服器對 HEAD 與 GET 的行為不同;遇到這種情況改用第二行,照常送 GET、傾印回應標頭、捨棄內容本體。回應的第一行就是狀態列,接著是完整標頭;查轉址時看 Location 指向哪裡,對新網址重跑一次,重複到落點為止,手動走完一條轉址鏈。這個方法預設不帶瀏覽器的 Cookie 與本地快取,看到的是接近陌生訪客的第一手答覆,工程師與 SEO 溝通規格時,指令輸出比截圖更沒有爭議。
開發者工具:看見單頁真相
查單一頁面的狀態碼,最快的工具就在瀏覽器裡。開啟 Chrome 開發者工具的 Network 面板,重新載入頁面,清單裡每個請求都帶著狀態碼欄位,點開主文件可以看到狀態列、回應標頭與轉址過程。面板設定裡勾選保留記錄,跨頁面的請求紀錄才會留住,觀察登入流程或結帳流程時特別好用。欄位太多時可以先學一個習慣:優先看 4xx、5xx,以及顯示 failed 或 blocked 的失敗請求,再依需要核對轉址鏈與 200 回應的內容。開發者工具還能做哪些 SEO 層面的檢查,F12 的 SEO 實戰用法有完整展開。
線上檢查工具:批次處理大量網址
改版之後要驗證幾百條網址的落點,逐條手查不切實際,這時用得上批次檢查工具。把從 sitemap 或轉址對應表整理出來的網址清單貼進批次狀態碼檢查工具 httpstatus.io,逐列觀察每個網址跟隨轉址後停在哪裡、帶什麼狀態碼、回了哪些標頭,等於把轉址對應表的驗收整批做完。使用節奏建議是:先抽一小段樣本確認規則無誤,再跑全量清單,清單龐大時分批進行,輸出留檔作為上線紀錄,日後有爭議時直接調出當時的落點。
Search Console:搜尋引擎親口告訴你
前三種方法看到的是你主動查詢的結果,Search Console 看到的是 Google 檢索視角的統計。網頁索引報表把未收錄原因分門別類,包括找不到(404)、軟性 404、伺服器錯誤(5xx)與重新導向錯誤,等於 Google 把檢索時撞到的狀態碼問題整理成報表送到你面前。單一網址的即時測試則能確認頁面當下是否可存取、具備可索引條件;實際收錄與否,要看網址檢查裡的 Google 索引資料。報表欄位怎麼讀、異常怎麼分級處理,網頁索引報表的完整解讀有逐項說明。
伺服器存取記錄:全站的最終真相
前述方法各有取樣範圍,想把請求看得完整,需要整合伺服器存取記錄與 CDN、代理層的記錄;源站日誌只記得到達源站的那一段,快取命中與邊緣轉址要往代理層的記錄找。把 log 檔拉出來統計各狀態碼的數量與分布,能看到哪些 URL 最常被請求、哪些路徑集中回 404、5xx 從什麼時間點開始暴增,也能看出特定用戶端的行為差異。這是技術 SEO 診斷裡視野最完整的一層,從檢索預算的消耗到錯誤的時間序都能對上,做法與分析角度整理在技術 SEO 指南的日誌分析章節。
遇到錯誤碼的查修順序
工具齊備之後,剩下的是紀律。看到異常狀態碼時照著一套固定順序走,能避免在錯誤的樓層找鑰匙。
- 先分類:看開頭數字確定問題屬於請求端、伺服器端或重新導向家族,先把查修範圍縮小。
- 讀標頭:Location 指向哪裡、Retry-After 說了什麼、WWW-Authenticate 要求什麼,標頭往往比狀態碼本身更接近病因。
- 定範圍:單頁還是全站、特定目錄還是隨機分布,用存取記錄或批次工具確認,範圍決定了要找的東西。
- 看時間:錯誤從什麼時間點開始,對照部署紀錄、主機商公告與規則變更,因果關係通常就浮出來了。
- 分層查:從瀏覽器快取、內容傳遞網路、負載平衡、源站主機到應用程式與資料庫,逐層確認回應是在哪一環變壞的。
- 修後驗:修復完成後用單頁檢查、批次抽查與 Search Console 檢查報表三種方式複核,確認搜尋引擎視角也恢復正常。
- 留紀錄:把範圍、原因、修復方式與驗證結果寫進事件紀錄,下一次同樣的數字再出現時,答案已經在手上。
這套順序的精神只有一句話:讓證據走在猜測前面。跳過定範圍與看時間這兩步,查修很容易變成憑印象改設定,結果原始狀態被覆蓋,線索一起消失。照順序走一遍有助於縮小範圍、避免誤改,也讓你與主機商、開發團隊溝通時手上隨時有具體事實。
三個排查情境
以下三個情境是業界常見劇本的整理,用來示範從症狀回推原因的思路,並非特定網站的實測紀錄;每個情境結尾列出的事項,就是修復後值得回頭驗收的指標。
案例一:改版後的接力轉址
一家內容網站歷經兩次改版,網址結構各換過一次。檢查時發現最舊的一批網址是這樣走的:舊網址 301 到第一次改版的中繼網址,中繼網址再 301 到第二次改版的位置,部分路徑甚至疊了四跳。表面上每個網址都有去處,實際上每一跳都是完整的請求與回應,多跳的接力不只拉長訪客的等待,也讓每一次檢索都得繞過好幾站才拿得到內容,檢索預算就這樣消耗在旅途中。處理方式是把所有歷代網址直接對應到最終位置,一跳到底,並用批次工具驗收全部清單的落點。收斂之後值得回頭驗收兩件事:批次抽查歷代網址是否都一跳到底,以及 Search Console 裡的重新導向錯誤是否不再增加。這個情境的教訓很簡單:轉址對應表要維護「最終位置」,而非「下一站」。團隊事後把對應表併入版本控管,之後每次改版的網址變更都先過一輪檢查,接力轉址再也沒有重新出現。
案例二:整週流量下滑的元兇是 403
某電商的搜尋流量連續一週下滑,網站本身開起來一切正常,主機商也表示沒有異常。轉而查存取記錄才發現,大量來自搜尋引擎爬蟲的請求收到 403,時間點與資安規則更新吻合:新的防護規則把某段 IP 範圍與高頻請求特徵列入拒絕名單,合法檢索器剛好被掃到。對一般訪客而言網站毫髮無傷,只有機器視角的網站呈現半關閉狀態,而流量下滑是唯一的對外症狀。處理方式是驗證爬蟲身分後,把已驗證的檢索器加入規則例外,並在防護後台設定警示,爬蟲命中拒絕規則時主動通知。這類問題的難處在於症狀出現在行銷報表,病因卻住在資安設定裡,兩邊的語言不通,狀態碼正是中間的翻譯官。
案例三:把維護期做對的 503
一個交易平台需要在促銷檔期前升級資料庫,預估停機九十分鐘。工程團隊沒有把網站關掉,也沒有把流量導向首頁,而是在負載平衡器上設定全站回 503,附上 Retry-After 標頭註明預計恢復時間,並準備一頁簡短的維護說明。維護結束後值得回頭驗收:網站是否不再持續回傳伺服器錯誤,檢索統計是否逐步恢復原本的節奏。同樣的停機,若換成錯誤頁導首頁或無限期的 502,劇本就會往收錄流失的方向走。差別不在停機本身,而在狀態碼傳達的語意:告訴機器晚點再來,機器就會晚點再來。
把狀態碼當成網站的體檢數值
狀態碼的價值,在於它是整條技術鏈上唯一共通的語言。瀏覽器、搜尋引擎、內容傳遞網路、主機與應用程式,每一環都用同一套三位數字回報狀況,讀懂它等於同時拿到所有環節的第一手陳述。你不需要背下整張代碼表,真正要用到的知識可以收斂成三件事:五個家族的語意、Location 與 Retry-After 這兩個標頭的線索、以及一套固定的查修順序。
把狀態碼檢查納入日常節奏,比出事再查更省力。改版與搬遷前先備妥網址對應表,上線後用批次工具驗收落點;每季打開網頁索引報表,看 Google 撞到了哪些 4xx 與 5xx;主機異常當下,先查存取記錄確定範圍再分層檢查。數字本身不嚇人,看不懂數字才會讓小問題長成大事故。從今天起,把報表裡每一個狀態碼都當成網站對你說的一句話,學會聽,它就會告訴你下一步該往哪裡走。